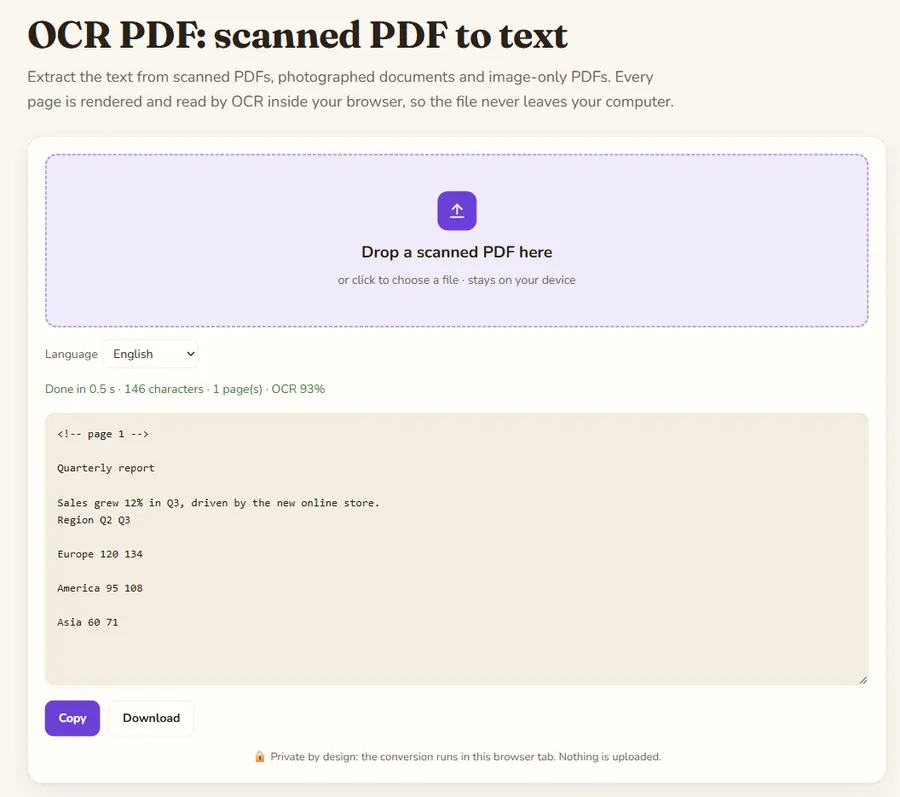
Récupérez le texte des PDF scannés et des documents photographiés. Chaque page est lue par OCR dans votre navigateur : le fichier ne quitte jamais votre ordinateur.
OCR PDF : PDF scanné en texte est un outil en ligne gratuit de Hack the Hydra. OCR gratuit pour PDF scannés : extrayez le texte de chaque page dans votre navigateur. Français avec accents, sans envoi, sans limite de pages.
Comment ça marche
Chaque page est affichée à environ 200 DPI puis lue par Tesseract, directement dans votre navigateur. Comptez quelques secondes par page.
PDF avec du texte
Si votre PDF contient déjà du texte sélectionnable, utilisez plutôt la conversion PDF en Markdown : elle est instantanée et garde les titres.
Durée et repères de page
Comptez quelques secondes par page sur un ordinateur récent ; gardez l’onglet ouvert pendant les longs documents. Le texte de chaque page est précédé d’un repère <!-- page N --> pour retrouver les limites de pages, et l’outil indique la confiance moyenne de la reconnaissance.
Meilleure précision
Choisissez la langue du document et partez d’un scan propre : environ 300 DPI, pages droites, bon contraste. Vérifiez toujours les montants, dates et noms propres avec l’original, car ce sont les caractères que l’OCR confond le plus.
Exemple
Un PDF scanné d’une page sans couche de texte (impossible d’y sélectionner du texte). Chaque page est rendue puis lue par OCR ; un repère de page est ajouté pour retrouver les limites de pages.
Entrée
(scanned PDF, 1 page, image only)
Invoice 2026-0142
Total due: 1,250.00 EUR
Payment within 30 days.
Résultat
<!-- page 1 -->

Invoice 2026-0142
Total due: 1,250.00 EUR
Payment within 30 days.
Mode d’emploi
- Déposez votre fichier dans le cadre, ou cliquez pour le choisir.
- Patientez quelques secondes pendant la conversion locale.
- Copiez le résultat ou téléchargez-le.
Questions fréquentes
C’est gratuit et sans limite ?
Oui. L’OCR tourne sur votre ordinateur, sans serveur.
Mon PDF est-il envoyé ?
Non. pdf.js et Tesseract fonctionnent dans votre onglet.
Les accents sont-ils reconnus ?
Oui, la langue est réglée sur le français par défaut.
Guides
API de conversion en masse
Des centaines de fichiers, des PDF scannés (OCR) ou de vrais tableaux ? Utilisez l’API, payée à l’usage, sans frais pour les fichiers en échec. Ouvrir l’API →
curl -X POST "https://api.apify.com/v2/acts/extas_corp~pdf-to-markdown/run-sync-get-dataset-items?token=YOUR_TOKEN" \
  -H "Content-Type: application/json" -d '{"pdfUrls":[{"url":"https://arxiv.org/pdf/1706.03762"}]}'
Utilisable par API, avec un plan gratuit : Document to Markdown API (RapidAPI) · Apify
 Hack the Hydra