Hack the Hydra

OCR PDF: PDF escaneado a texto

Extrae el texto de PDF escaneados y documentos fotografiados. Cada página se lee con OCR en tu navegador: el archivo nunca sale de tu ordenador.

🔒 Privado: la conversión se hace en esta pestaña. No se sube nada.

OCR PDF: PDF escaneado a texto es una herramienta en línea gratuita de Hack the Hydra. OCR gratis para PDF escaneados: extrae el texto de cada página en tu navegador. Español con acentos y ñ, sin subir archivos ni límite de páginas.

100 % gratisSin subir archivos: funciona en tu navegadorSin registro
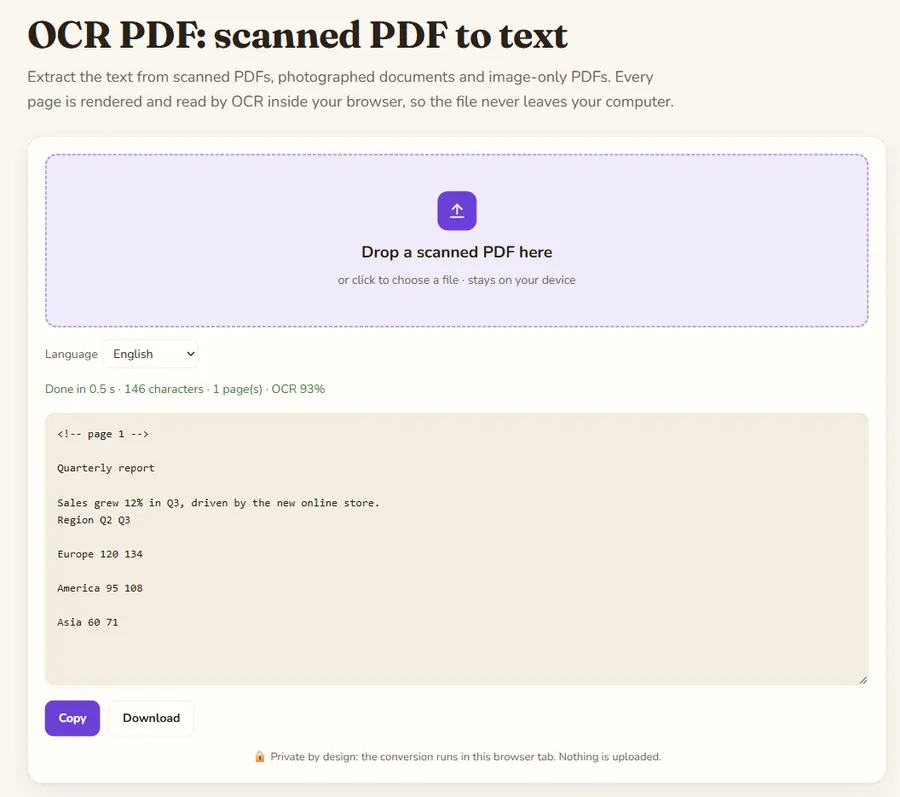
OCR PDF: PDF escaneado a texto: la herramienta con un archivo de ejemplo convertido

Cómo funciona

Cada página se renderiza a unos 200 DPI y Tesseract la lee en tu navegador. Calcula unos segundos por página.

Duración y marcas de página

Cuenta con unos segundos por página en un ordenador reciente; mantén la pestaña abierta en documentos largos. El texto de cada página va precedido de una marca <!-- page N --> para localizar los límites entre páginas, y la herramienta indica la confianza media del reconocimiento.

Más precisión

Elige el idioma del documento y parte de un escaneo limpio: unos 300 DPI, páginas rectas y buen contraste. Comprueba siempre importes, fechas y nombres con el original, porque son los caracteres que el OCR confunde más.

Ejemplo

Un PDF escaneado de una página sin capa de texto (no se puede seleccionar texto). Cada página se renderiza y se lee con OCR; se añade una marca de página para localizar los límites entre páginas.

Entrada

(scanned PDF, 1 page, image only)
Invoice 2026-0142
Total due: 1,250.00 EUR
Payment within 30 days.

Resultado

<!-- page 1 -->

Invoice 2026-0142
Total due: 1,250.00 EUR
Payment within 30 days.

Cómo usar

  1. Suelta tu archivo en el recuadro o haz clic para elegirlo.
  2. Espera unos segundos mientras se convierte localmente.
  3. Copia el resultado o descárgalo.

Preguntas frecuentes

¿Es gratis y sin límite?

Sí, el OCR funciona en tu ordenador.

¿Se sube mi PDF?

No.

Guías

API de conversión masiva

¿Cientos de archivos, PDF escaneados (OCR) o tablas reales? Usa la API de pago por uso; los archivos fallidos no se cobran. Abrir la API →

curl -X POST "https://api.apify.com/v2/acts/extas_corp~pdf-to-markdown/run-sync-get-dataset-items?token=YOUR_TOKEN" \
  -H "Content-Type: application/json" -d '{"pdfUrls":[{"url":"https://arxiv.org/pdf/1706.03762"}]}'

Úsalo por API, con plan gratuito: Document to Markdown API (RapidAPI) · Apify

Otras herramientas

Convertir PDF a MarkdownImagen a texto (OCR gratis)Convertir Word a MarkdownExcel y CSV a tablas MarkdownConvertir PDF a textoUnir archivos PDFDividir PDF: extraer páginasGirar PDFConvertir JPG a PDFConvertir PDF a JPGConvertidor de imágenes: PNG, JPG, WebPComprimir imagen: JPG y WebPConvertir PNG a JPGConvertir JPG a PNGConvertir WebP a PNGGenerador de código QRContador de palabrasConvertidor de mayúsculas y minúsculasFormateador y validador JSONCodificar y decodificar Base64Codificador y decodificador de URLGenerador de UUID v4Generador de contraseñas segurasGenerador de Lorem IpsumConversor de JSON a CSVEliminar líneas duplicadasConversor de timestamp UnixConversor de JSON a YAMLComparar dos textosRedimensionar imagenCalculadora de porcentajesCalculadora de edadGenerador de hash (SHA-256, SHA-1, SHA-512)Convertidor de colores: HEX, RGB, HSLCalcular días entre dos fechasConvertidor de YAML a JSONConversor de unidadesDecodificador JWTConvertidor binario, hexadecimal, decimal y octalConvertidor de números romanosProbador de regexExplicar una expresión cron