Hack the Hydra

OCR PDF: gescanntes PDF in Text

Extrahieren Sie den Text aus gescannten PDFs und fotografierten Dokumenten. Jede Seite wird im Browser per OCR gelesen: Die Datei verlässt Ihren Computer nie.

🔒 Privat: Die Umwandlung läuft in diesem Tab. Nichts wird hochgeladen.

OCR PDF: gescanntes PDF in Text ist ein kostenloses Online-Tool von Hack the Hydra. Kostenlose OCR für gescannte PDFs: Text jeder Seite direkt im Browser extrahieren. Deutsch mit Umlauten, ohne Upload, ohne Seitenlimit.

100 % kostenlosKein Upload: läuft im BrowserOhne Anmeldung
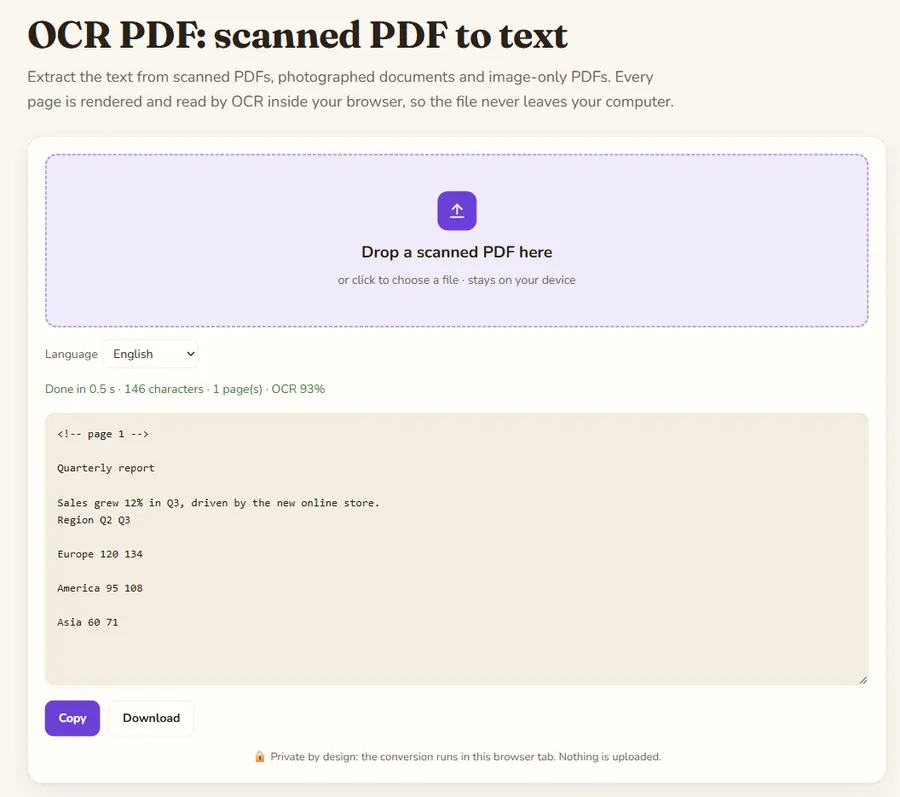
OCR PDF: gescanntes PDF in Text: das Tool mit einer konvertierten Beispieldatei

So funktioniert es

Jede Seite wird mit etwa 200 DPI gerendert und von Tesseract im Browser gelesen. Rechnen Sie mit einigen Sekunden pro Seite.

Dauer und Seitenmarken

Rechnen Sie mit einigen Sekunden pro Seite auf einem aktuellen Computer; lassen Sie den Tab bei langen Dokumenten geöffnet. Vor dem Text jeder Seite steht eine Marke <!-- page N -->, damit Sie Seitengrenzen wiederfinden, und das Tool nennt die durchschnittliche Erkennungs-Konfidenz.

Bessere Genauigkeit

Wählen Sie die Sprache des Dokuments und starten Sie mit einem sauberen Scan: etwa 300 DPI, gerade Seiten, guter Kontrast. Prüfen Sie Beträge, Daten und Namen immer am Original, denn diese Zeichen verwechselt OCR am häufigsten.

Beispiel

Ein einseitiges gescanntes PDF ohne Textebene (Text lässt sich nicht markieren). Jede Seite wird gerendert und per OCR gelesen; eine Seitenmarke zeigt, wo die Seiten beginnen.

Eingabe

(scanned PDF, 1 page, image only)
Invoice 2026-0142
Total due: 1,250.00 EUR
Payment within 30 days.

Ergebnis

<!-- page 1 -->

Invoice 2026-0142
Total due: 1,250.00 EUR
Payment within 30 days.

So funktioniert es

  1. Datei in das Feld ziehen oder zum Auswählen klicken.
  2. Einige Sekunden warten, während lokal umgewandelt wird.
  3. Ergebnis kopieren oder herunterladen.

Häufige Fragen

Kostenlos und ohne Limit?

Ja, die OCR läuft auf Ihrem Computer.

Wird mein PDF hochgeladen?

Nein.

Anleitungen

API für Massenumwandlung

Hunderte Dateien, gescannte PDFs (OCR) oder echte Tabellen? Nutzen Sie die API mit Abrechnung pro Nutzung; fehlgeschlagene Dateien sind kostenlos. API öffnen →

curl -X POST "https://api.apify.com/v2/acts/extas_corp~pdf-to-markdown/run-sync-get-dataset-items?token=YOUR_TOKEN" \
  -H "Content-Type: application/json" -d '{"pdfUrls":[{"url":"https://arxiv.org/pdf/1706.03762"}]}'

Per API nutzbar, mit kostenlosem Tarif: Document to Markdown API (RapidAPI) · Apify

Weitere Tools

PDF in Markdown umwandelnBild zu Text (kostenlose OCR)Word in Markdown umwandelnExcel (XLSX) und CSV in Markdown-TabellenPDF in Text umwandelnPDF zusammenfügenPDF teilen: Seiten extrahierenPDF drehenJPG in PDF umwandelnPDF in JPG umwandelnBildkonverter: PNG, JPG, WebPBild komprimieren: JPG und WebPPNG in JPG umwandelnJPG in PNG umwandelnWebP in PNG umwandelnQR-Code-GeneratorWörter zählenGroß- und Kleinschreibung umwandelnJSON-Formatter und ValidatorBase64 kodieren und dekodierenURL-Encoder und -DecoderUUID-v4-GeneratorSicherer Passwort-GeneratorLorem-Ipsum-GeneratorJSON in CSV umwandelnDoppelte Zeilen entfernenUnix-Timestamp-UmrechnerJSON in YAML umwandelnTexte vergleichenBildgröße ändernProzentrechnerAltersrechnerHash-Generator (SHA-256, SHA-1, SHA-512)Farbkonverter: HEX, RGB, HSLTage zwischen zwei Daten berechnenYAML in JSON umwandelnEinheiten-UmrechnerJWT-DecoderBinär-, Hex-, Dezimal- und Oktal-UmrechnerRömische Zahlen umrechnenRegex-TesterCron-Ausdruck erklären