 Hack the Hydra
Cómo extraer texto de un PDF escaneado
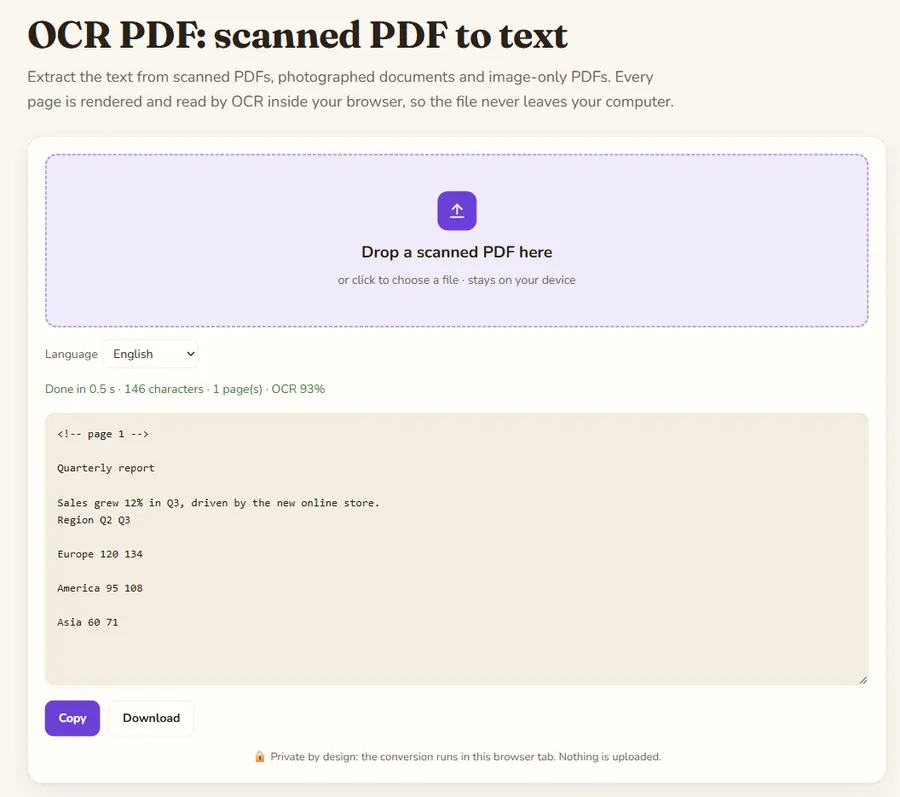
Un PDF escaneado es solo una serie de imágenes de páginas, así que hace falta OCR (reconocimiento óptico de caracteres). Abra la herramienta OCR PDF, suba el archivo, elija el idioma del documento y empiece. Cada página se lee en su navegador y obtiene el texto para copiar o descargar.
Herramienta gratuita OCR PDF →
Primero: ¿es realmente un escaneado?
Abra el PDF e intente seleccionar una frase con el ratón, o busque una palabra con Ctrl+F. Si funciona, el archivo ya contiene texto y no necesita OCR: use PDF a texto, instantáneo y exacto. Si no se selecciona nada, o la selección resalta bloques del tamaño de una página, es un escaneado.
Los pasos
- Abra OCR PDF.
- Suba el PDF escaneado.
- Elija el idioma del documento. Es importante: un idioma incorrecto provoca errores con las tildes y los caracteres especiales. Hay siete idiomas disponibles.
- Empiece y mantenga la pestaña abierta. Cada página se dibuja a unos 200 DPI y la lee Tesseract OCR.
- Copie el texto o descárguelo.
Calcule unos segundos por página en un ordenador reciente; un documento largo tarda proporcionalmente más.
¿Cómo mejorar la precisión?
- Escanee a unos 300 DPI si aún tiene el papel. Más no siempre es mejor.
- Mantenga las páginas rectas. Una página torcida o girada empeora el resultado; corríjala antes con Girar PDF.
- Cuide el contraste: el texto negro sobre una hoja blanca y limpia se lee mejor. Las sombras de una foto y la transparencia del reverso de un papel fino añaden errores.
- Un solo idioma cada vez. Las páginas multilingües dan peores resultados.
¿Qué esperar del resultado?
El OCR nunca es perfecto. Espere errores con letra pequeña, sellos, escritura a mano, tablas y diseños a varias columnas. La herramienta entrega texto, no un nuevo PDF con capa de texto invisible. Revise siempre cifras, nombres y fechas comparándolos con el original.
Después de la extracción
Pegue el texto en un documento y límpielo de una sola pasada: corrija los errores evidentes (el número 0 y la letra O, o el 1 y la l, son confusiones clásicas), una las líneas cortadas por la maquetación y elimine encabezados y números de página que se repiten.
Un apunte
Si el documento está en varios idiomas, haga una pasada por cada idioma con las páginas correspondientes y junte después los resultados. Guarde siempre el PDF original junto al texto extraído: si más adelante duda de una cifra, podrá comprobarla en la imagen de la página en pocos segundos.
Pocas páginas o fotos
Para una página fotografiada o una captura de pantalla, Imagen a texto hace el mismo trabajo sin pasar por un PDF.
Privacidad: el archivo se procesa en la pestaña de su navegador y no se envía a ningún servidor. Una vez cargada la página, la herramienta sigue funcionando aunque se quede sin conexión.
FAQ
¿Cómo sé si mi PDF es un escaneado?
Intente seleccionar texto o buscar con Ctrl+F. Si no se selecciona ni se encuentra nada, las páginas son imágenes.
¿Puede leer escritura a mano?
No de forma fiable. El OCR funciona mejor con texto impreso; la letra manuscrita da malos resultados.
¿Hay límite de páginas?
La herramienta no impone límite. Los archivos largos solo necesitan más tiempo y que la pestaña siga abierta.
¿Crea un PDF con texto buscable?
No. Entrega el texto extraído, no un PDF nuevo con capa de texto.
Actualizado: noviembre de 2026. Los archivos se procesan en su navegador y no se envían a ningún servidor.