 Hack the Hydra
PDF in Markdown für LLMs umwandeln
Kurz gesagt: Extrahieren Sie das PDF als Markdown (Überschriften, Listen, Tabellen), entfernen Sie wiederkehrende Kopf- und Fußzeilen und fügen Sie den Text dann in den Chat ein oder teilen Sie ihn für die Suche an den Überschriften in Chunks. Nutzen Sie OCR für gescannte Seiten. Ein kostenloser Browser-Konverter bewältigt einzelne Dateien, eine API ganze Stapel.
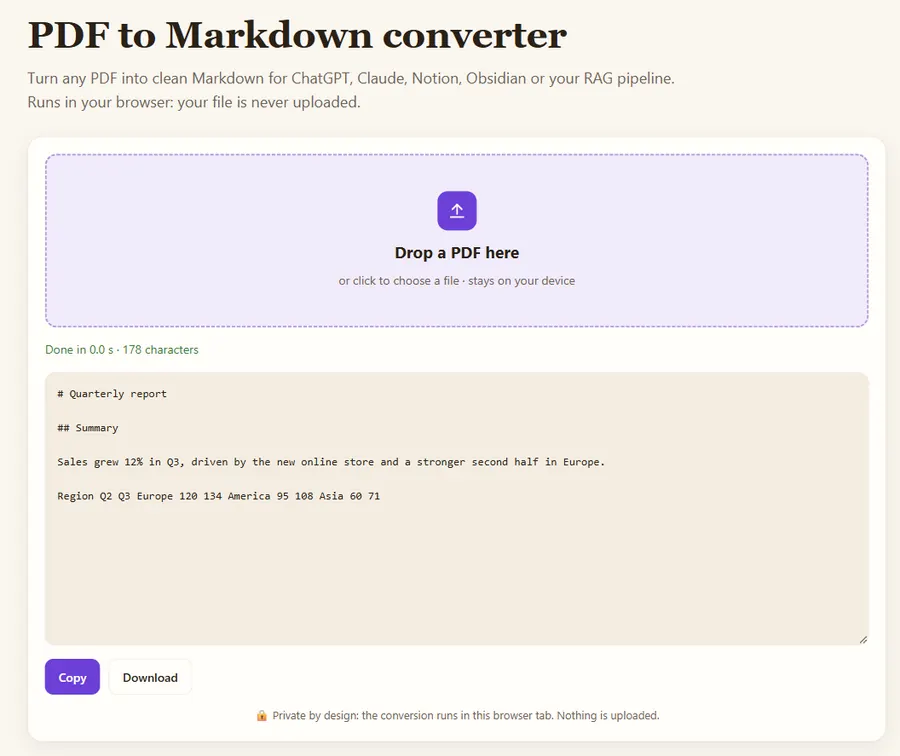
Free PDF to Markdown converter →
1. Extrahieren
Nutzen Sie einen Konverter, der die Struktur erhält. Öffnen Sie den PDF-in-Markdown-Konverter, legen Sie Ihre Datei ab und laden Sie die .md herunter. Ist das Ergebnis fast leer, ist das PDF ein Scan: Nutzen Sie OCR oder die API.
2. Bereinigen
Löschen Sie laufende Kopfzeilen, Seitenzahlen, Inhaltsverzeichnisse und juristische Standardtexte. Sie verschwenden Tokens und verfälschen die Suche.
3. Strukturieren
Prüfen Sie, ob aus den Abschnittstiteln Markdown-Überschriften geworden sind. Falls nicht, ergänzen Sie # und ## selbst: Auf Überschriften stützen sich sowohl das Modell als auch Ihr Chunker.
4. Verwenden
Chat: Fügen Sie das Markdown ein und bitten Sie das Modell, die verwendete Überschrift zu nennen. RAG: An den Überschriften teilen, Chunks auf etwa 500–1.000 Tokens begrenzen, den Überschriftenpfad als Metadaten speichern. Siehe PDF to Markdown for RAG (auf Englisch).
5. Skalieren
Für Hunderte von Dateien rufen Sie die PDF-to-Markdown-API aus Ihrer Pipeline auf. Sie erkennt Tabellen, liest gescannte Seiten per OCR und berechnet nur erfolgreich verarbeitete Dateien.
Beispiel: vor und nach der Bereinigung
So sieht eine Berichtsseite direkt nach der Extraktion oft aus:
Jahresbericht 2025 – Vertraulich
12
Umsatz
Der Umsatz steigt im Geschäfts-
jahr um 12 %, getragen vom Export.
Und nach den Schritten 2 und 3:
## Umsatz

Der Umsatz steigt im Geschäftsjahr um 12 %,
getragen vom Export.
Die wiederholte Kopfzeile und die Seitenzahl sind weg, das getrennte Wort ist wieder ganz und die Zwischenüberschrift ist eine echte Überschrift. In einem 50-seitigen Dokument kommen solche Wiederholungen dutzendfach vor: Sie zu entfernen spart Tokens und verhindert, dass alle Chunks gleich aussehen.
Prompt-Vorlage
Unten steht ein Dokument in Markdown zwischen <doc>-Tags.
Antworte nur auf Grundlage des Dokuments. Steht die Antwort nicht darin, sag es.
Nenne für jede Aussage die Überschrift des verwendeten Abschnitts.

<doc>
(Markdown hier einfügen)
</doc>

Frage: ...
Die Bitte um die Abschnittsüberschrift macht jede Antwort in Sekunden überprüfbar. Siehe auch wie man ChatGPT ein PDF übergibt.
Checkliste vor der Nutzung
- Der Text folgt der Lesereihenfolge, auch bei zweispaltigen Seiten.
- Kapitel und Abschnitte sind Überschriften mit
#und##. - Tabellen behalten Zeilen und Spalten; drei Zahlen mit dem PDF verglichen.
- Keine Kopf-, Fußzeilen oder Seitenzahlen mehr mitten im Text.
- Gescannte Seiten enthalten Text (sonst: OCR).
Wie viel Text passt in einen Chat?
Als Faustregel entspricht ein Token im Englischen etwa drei Viertel eines Wortes, im Deutschen wegen der langen Komposita oft weniger. Ein 30-seitiger Bericht mit rund 15.000 Wörtern passt in die großen Kontextfenster aktueller Modelle, aber jede überflüssige Kopfzeile kostet Platz und lenkt ab. Kürzen Sie deshalb zuerst auf die relevanten Kapitel; bei Dokumentensammlungen ist eine Suche über Chunks (RAG) günstiger als alles in einen Chat zu kopieren.
FAQ
Warum Markdown statt Klartext?
Markdown erhält die Struktur (Überschriften, Listen, Tabellen) fast ohne Token-Mehrkosten, was sowohl die Antworten als auch die Suche verbessert.
Wie viele Tokens hat eine PDF-Seite?
Typischerweise 400 bis 800 Tokens englischer Text pro Seite, bei dichten Fachartikeln mehr.
Aktualisiert: November 2026. Die Dateien werden in Ihrem Browser verarbeitet und nicht hochgeladen.