 Hack the Hydra
Cómo convertir PDF a Markdown para LLM
En breve: extrae el PDF a Markdown (títulos, listas, tablas), elimina los encabezados y pies de página repetidos y luego pega el texto en el chat o divídelo por títulos en fragmentos para la recuperación. Usa OCR para las páginas escaneadas. Un conversor gratuito en el navegador sirve para archivos sueltos y una API para lotes.
Free PDF to Markdown converter →
1. Extraer
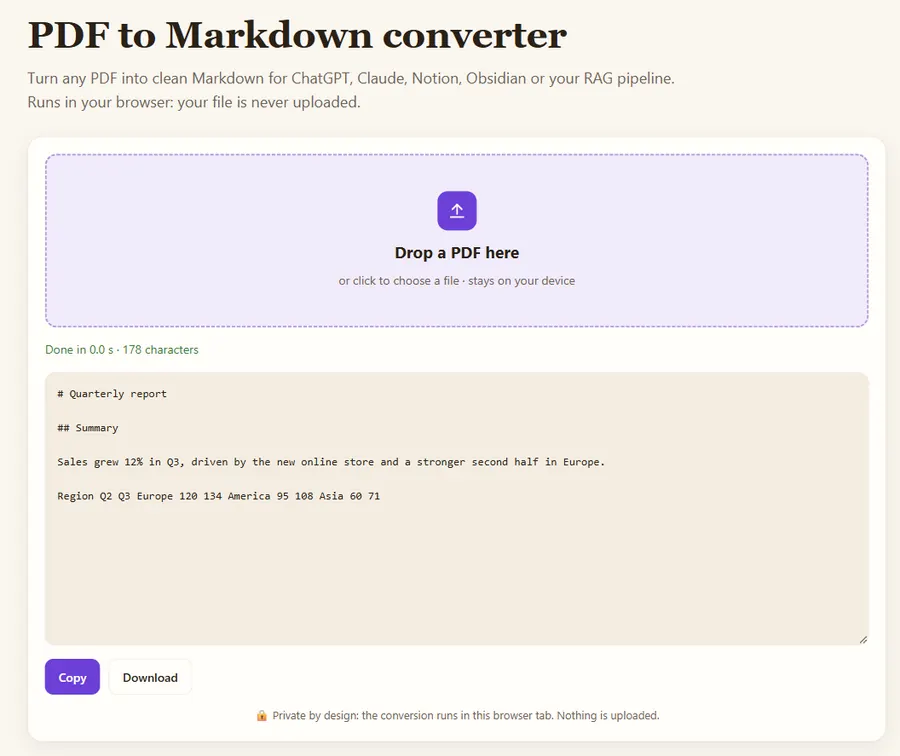
Usa un conversor que conserve la estructura. Abre el conversor de PDF a Markdown, suelta tu archivo y descarga el .md. Si el resultado está casi vacío, el PDF es un escaneo: usa el OCR o la API.
2. Limpiar
Elimina los encabezados repetidos, los números de página, los índices y el texto legal estándar. Gastan tokens y ensucian la recuperación.
3. Estructurar
Comprueba que los títulos de sección se hayan convertido en títulos Markdown. Si no, añade # y ## tú mismo: los títulos son en lo que se apoyan tanto el modelo como tu divisor de fragmentos.
4. Usar
Chat: pega el Markdown y pide al modelo que cite el título que usó. RAG: divide por títulos, limita los fragmentos a unos 500–1.000 tokens y guarda la ruta de títulos como metadato. Consulta PDF to Markdown for RAG (en inglés).
5. Escalar
Para cientos de archivos, llama a la API de PDF to Markdown desde tu flujo. Detecta tablas, aplica OCR a las páginas escaneadas y solo cobra los archivos procesados con éxito.
Ejemplo: antes y después de limpiar
Así queda a menudo una página de informe justo después de la extracción:
Informe anual 2025 – Confidencial
12
Ventas
Las ventas crecen un 12 % en el ejer-
cicio, impulsadas por la exportación.
Y después de los pasos 2 y 3:
## Ventas

Las ventas crecen un 12 % en el ejercicio,
impulsadas por la exportación.
La cabecera repetida y el número de página desaparecen, la palabra cortada se une y el subtítulo pasa a ser un título real. En un documento de 50 páginas estas repeticiones se cuentan por decenas: quitarlas reduce los tokens y evita que todos los fragmentos se parezcan.
Plantilla de prompt
Abajo hay un documento en Markdown entre etiquetas <doc>.
Responde solo a partir del documento. Si la respuesta no está, dilo.
Para cada afirmación, cita el título de la sección que usaste.

<doc>
(pega aquí el Markdown)
</doc>

Pregunta: ...
Pedir el título de la sección permite comprobar cada respuesta en segundos. Consulta también cómo dar un PDF a ChatGPT.
Lista de comprobación antes de usarlo
- El texto sigue el orden de lectura, también en páginas a dos columnas.
- Capítulos y secciones son títulos
#y##. - Las tablas conservan filas y columnas; tres cifras comprobadas con el PDF.
- Sin cabeceras, pies ni números de página en medio del texto.
- Las páginas escaneadas tienen texto (si no: OCR).
FAQ
¿Por qué Markdown en lugar de texto plano?
Markdown conserva la estructura (títulos, listas, tablas) con un coste casi nulo en tokens, lo que mejora tanto las respuestas como la recuperación.
¿Cuántos tokens tiene una página de PDF?
Normalmente de 400 a 800 tokens de texto en inglés por página, más en los artículos densos.
Actualizado: noviembre de 2026. Los archivos se procesan en su navegador y no se envían a ningún servidor.