 Hack the Hydra
Ein PDF an ChatGPT übergeben
Kurz gesagt: Bei kurzen, textbasierten PDFs funktioniert der Upload der Datei. Bei langen, komplexen oder gescannten PDFs wandeln Sie das PDF zuerst in Markdown um, entfernen Sie nicht benötigte Teile und fügen es mit einem Prompt ein, der ChatGPT auffordert, nur aus dem Dokument zu antworten und die Abschnittsüberschrift zu nennen. Gescannte PDFs brauchen zuerst OCR.
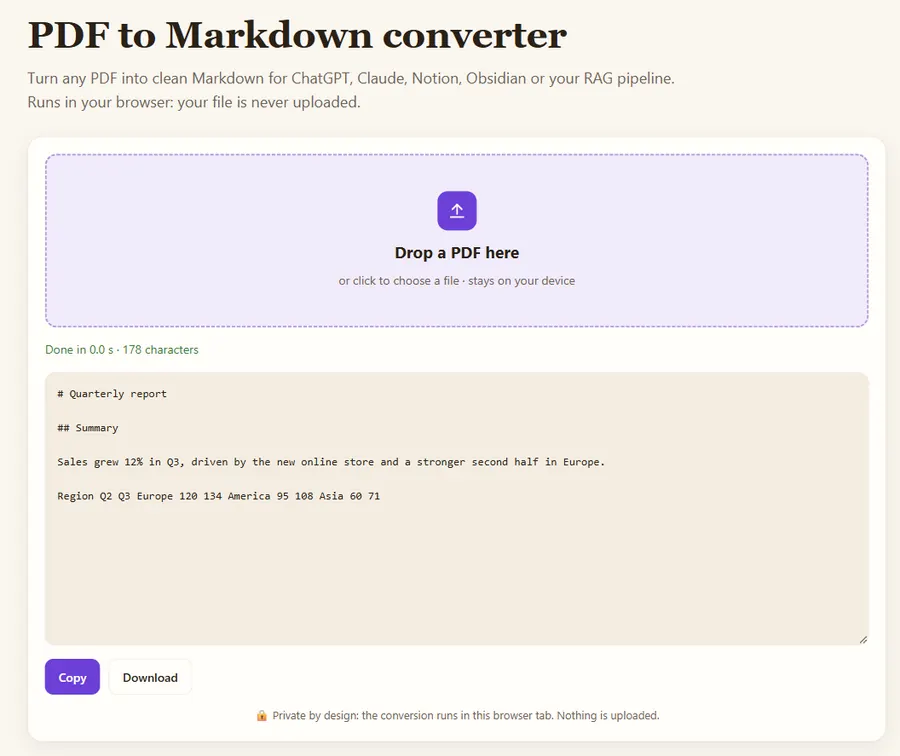
Free PDF to Markdown converter →
Option 1: das PDF hochladen
Am schnellsten und für kurze, textbasierte Dokumente völlig ausreichend. Der Nachteil: Sie sehen nicht, was das Modell tatsächlich extrahiert hat. Wiederkehrende Kopfzeilen, kaputte Tabellen und fehlende gescannte Seiten bleiben unsichtbar.
Option 2: Markdown einfügen (am zuverlässigsten)
Wandeln Sie die Datei mit dem PDF-in-Markdown-Konverter um. Sie können den Text prüfen und kürzen, und anhand der Überschriften kann ChatGPT den genauen verwendeten Abschnitt nennen. Das ist die beste Option für Verträge, Spezifikationen, Fachartikel und Handbücher.
Option 3: Klartext einfügen
Beim Kopieren von Text aus einem PDF-Viewer geht die Struktur verloren: Spalten vermischen sich, Wörter mit Silbentrennung brechen auseinander, und Tabellen werden zu einem Zahlenbrei. Vermeiden Sie das bei allem, was länger als eine Seite ist.
Prompt-Vorlage
Unten steht ein Dokument in Markdown zwischen <doc>-Tags.
Antworte nur anhand des Dokuments. Steht die Antwort nicht darin, sage das.
Nenne zu jeder Aussage die Abschnittsüberschrift, die du verwendet hast.

<doc>
(Markdown hier einfügen)
</doc>

Frage: ...
Was ist mit langen PDFs?
Passt das Dokument nicht hinein, teilen Sie das Markdown an seinen #- und ##-Überschriften und arbeiten Sie Abschnitt für Abschnitt, oder behalten Sie nur die für Ihre Frage relevanten Abschnitte.
Was ist mit gescannten PDFs?
Liefert der Konverter fast keinen Text, ist das PDF ein Scan. Schicken Sie die Seitenbilder durch die Bild-zu-Text-OCR oder nutzen Sie die API, die gescannte Seiten automatisch per OCR liest.
Beispiel: ein 40-seitiger Lieferantenvertrag
Sie möchten die Kündigungsfrist und den Verzugszins aus einem 40-seitigen Vertrag wissen. Das PDF hochzuladen und „Wie lang ist die Kündigungsfrist?“ zu fragen klappt oft, aber wenn nicht, wissen Sie nicht, ob die Klausel übersehen, mit einer Fußzeile vermischt oder nie extrahiert wurde.
- Wandeln Sie das PDF mit dem PDF-in-Markdown-Konverter um: Klauseln werden zu Überschriften wie
## 12. Kündigung. - Löschen Sie, was Sie nicht brauchen: Deckblatt, Unterschriftsblöcke, Preisanhänge. Meist bleiben etwa zehn relevante Seiten.
- Fügen Sie den Text mit der Anweisung ein, nur aus dem Dokument zu antworten und den Abschnitt zu nennen.
Die Antwort lautet dann etwa „§ 12.2: 90 Tage Kündigungsfrist; § 8.4: 1,5 % pro Monat Verzug“. Beide Zahlen prüfen Sie im Markdown in Sekunden: Sie sehen genau, was das Modell gelesen hat.
Welche Methode passt?
| Ihr PDF | Methode | Warum |
|---|---|---|
| 1 bis 10 Seiten normaler Text | Datei hochladen | Schnell, wenig Risiko |
| Langer Bericht, Vertrag, Handbuch | Markdown einfügen | Sie kürzen ihn, Überschriften machen Antworten überprüfbar |
| Zahlentabellen | Markdown, Tabellen prüfen | Kopierter Text vermischt Zeilen und Spalten |
| Gescannte oder fotografierte Seiten | Erst OCR, dann einfügen | Ein Scan hat keine Textebene |
| Hunderte PDFs | Stapelkonvertierung, dann Suche (RAG) | Zu groß für einen einzigen Chat |
Was sind häufige Fehler?
- Nach einer Seitenzahl fragen: „Was steht auf Seite 17?“ scheitert, weil extrahierter Text Seitenzahlen selten behält. Nennen Sie die Abschnittsüberschrift oder einen Satz.
- Tabellenzahlen ungeprüft übernehmen: Vergleichen Sie sie mit dem Original-PDF.
- Mehrere Dokumente ohne Namen einfügen: Umschließen Sie jedes mit eigenen Tags, damit klar ist, woher eine Angabe stammt.
- „Wenn es nicht im Dokument steht, sag es“ vergessen: Ohne diese Anweisung füllt das Modell Lücken womöglich mit einer plausiblen Vermutung.
FAQ
Warum übersieht ChatGPT Dinge in meinem PDF?
Meist, weil der extrahierte Text unvollständig oder in falscher Reihenfolge ist (Spalten, Tabellen, gescannte Seiten). Die Umwandlung in Markdown und die Kontrolle des Ergebnisses löst die meisten Fälle.
Ist es sicher, vertrauliche PDFs einzufügen?
Der Konverter auf dieser Seite läuft in Ihrem Browser und lädt nichts hoch. Was Sie in ChatGPT einfügen, unterliegt Ihrem ChatGPT-Tarif und Ihren Dateneinstellungen.
Aktualisiert: November 2026. Die Dateien werden in Ihrem Browser verarbeitet und nicht hochgeladen.